Bootcamp en vivo · inicia 4 nov 2026 · en 4 días

Conviértete en Databricks Data Engineer

Del Lakehouse a producción: pipelines incrementales, calidad de datos, orquestación, CI/CD y gobierno con Unity Catalog. Terminas con un proyecto end-to-end y listo para la certificación oficial.

Precio regular US$ 300.00 · ahorras 23%

Descargar brochure (PDF)
  • +5,000 alumnos formados
  • Ingenieros en ejercicio como instructores
  • Tarjeta o PayPal · pago seguro
Inicio
4 nov 2026 · en 4 días
En vivo
36 horas
Temario
12 módulos · 71 lecciones
Nivel
Desde cero

// Preparación para certificaciones

Listo para certificarte

El temario cubre lo que evalúan estos exámenes y el módulo 12 incluye un simulacro con estrategias para aprobar.

Insignia Databricks Certified Data Engineer Associate

Databricks

Databricks Certified Data Engineer Associate

La certificación oficial de Databricks para ingenieros de datos.
Insignia Microsoft Certified: Azure Databricks Data Engineer Associate

Microsoft · Examen DP-750

Microsoft Certified: Azure Databricks Data Engineer Associate

La nueva certificación de Microsoft para ingeniería de datos en Azure Databricks.

El examen oficial se rinde directamente con el proveedor y se paga aparte.

// Horario

Lunes y miércoles · en vivo

Del 4 de noviembre al 16 de diciembre · 36 horas en total

6:00 p.m.

México

7:00 p.m.

Perú · Colombia · Ecuador

8:00 p.m.

Bolivia

9:00 p.m.

Chile · Argentina · Paraguay

Miércoles 9 de diciembre sin clase (feriado nacional).

// Al terminar

Lo que vas a saber hacer

  • Diseñar un Lakehouse

    Arquitectura medallion Bronze, Silver y Gold sobre Delta Lake, con ACID, time travel y optimización.

  • Ingestar de forma incremental

    Auto Loader, Structured Streaming y CDC con SCD Tipo 1 y 2 desde archivos, bases de datos y SaaS.

  • Pipelines declarativos con calidad

    Lakeflow Declarative Pipelines con expectations que avisan, descartan o detienen ante datos malos.

  • Orquestar y depurar

    Jobs con dependencias, triggers por evento, reintentos, repair runs y lectura de la Spark UI.

  • Desplegar como software

    Git, Databricks Asset Bundles y CI/CD con GitHub Actions en dev, staging y prod.

  • Gobernar y abrir el dato a la IA

    Unity Catalog con permisos y linaje, Vector Search para RAG y Genie para consultar en lenguaje natural.

01Una sola plataforma. Ingesta, transformación, calidad, orquestación, gobierno e IA en el mismo lugar. Aprendes el flujo completo, no herramientas sueltas.

02Lo que piden los data teams. Databricks es la plataforma donde muchas empresas construyen hoy sus pipelines y sus casos de IA. Saber operarla en producción te diferencia.

03Puente hacia la IA. Los agentes y el RAG dependen de datos limpios y gobernados. El data engineer que domina eso es quien los hace posibles.

Inicia en 4 días

US$ 230.00US$ 300.00

Reservar mi cupo

Proyecto end-to-end

Construyes un pipeline real, de la ingesta a la IA

El último módulo une todo lo aprendido en una solución que puedes mostrar en entrevistas.

  1. 01

    Auto Loader

    Ingesta incremental

  2. 02

    Bronze

    Dato crudo

  3. 03

    Silver

    Limpio y validado

  4. 04

    Gold

    Listo para negocio

  5. 05

    Jobs + CI/CD

    Orquestado y desplegado

  6. 06

    Unity Catalog

    Gobernado

  7. 07

    Genie

    Consultado en lenguaje natural

// Stack que vas a dominar

  • DatabricksDatabricks
  • Apache SparkApache Spark
  • PythonPython
  • Delta LakeDelta Lake
  • Unity CatalogUnity Catalog
  • GitGit
  • GitHub ActionsGitHub Actions

// Temario

12 módulos · 71 lecciones

01Databricks Lakehouse & Data Intelligence
  • ›Qué es el Lakehouse y en qué se diferencia de un Data Warehouse y un Data Lake
  • ›Arquitectura de la plataforma Databricks: control plane y compute plane
  • ›Workspaces, clusters, SQL Warehouses y serverless compute
  • ›Notebooks, Repos y entorno de trabajo
  • ›Databricks Data Intelligence Platform y el rol de la IA en la plataforma
02Data Engineering con PySpark & Spark SQL
  • ›Fundamentos de Apache Spark: DataFrames, transformaciones y acciones
  • ›Lectura y escritura de datos en múltiples formatos (CSV, JSON, Parquet)
  • ›Transformaciones esenciales: select, filter, joins y agregaciones
  • ›Spark SQL: vistas temporales, CTEs y funciones de ventana
  • ›Funciones de alto orden y manejo de datos anidados (arrays, structs)
  • ›Buenas prácticas de rendimiento y particionamiento
03Delta Lake & Data Management
  • ›Anatomía de una tabla Delta: Parquet + transaction log
  • ›Transacciones ACID y control de concurrencia
  • ›Operaciones DML: INSERT, UPDATE, DELETE y MERGE
  • ›Time Travel, RESTORE y versionado de datos
  • ›Schema enforcement y schema evolution
  • ›Optimización: OPTIMIZE, Z-ORDER, Liquid Clustering y VACUUM
04Data Ingestion con Auto Loader & Streaming
  • ›Conceptos de procesamiento batch vs. streaming
  • ›Structured Streaming: triggers, checkpoints y output modes
  • ›Auto Loader: ingesta incremental de archivos desde cloud storage
  • ›Schema inference, evolution y rescued data column
  • ›COPY INTO vs. Auto Loader: cuándo usar cada uno
  • ›Arquitectura medallion: capas Bronze, Silver y Gold
05Lakeflow Connect & Change Data Capture
  • ›Introducción a Lakeflow Connect y conectores administrados
  • ›Ingesta desde bases de datos y aplicaciones SaaS
  • ›Fundamentos de Change Data Capture (CDC)
  • ›APPLY CHANGES INTO y manejo de SCD Tipo 1 y Tipo 2
  • ›Manejo de datos tardíos y eventos fuera de orden
06Lakeflow Declarative Pipelines & Data Quality
  • ›Paradigma declarativo: streaming tables y materialized views
  • ›Construcción de pipelines con SQL y Python
  • ›Expectations: reglas de calidad de datos (warn, drop, fail)
  • ›Modos de ejecución, actualizaciones y full refresh
  • ›Monitoreo del pipeline, event log y linaje
  • ›Patrones de diseño para pipelines en producción
07Lakeflow Jobs, Orchestration & Troubleshooting
  • ›Creación de Jobs, tasks y dependencias
  • ›Parámetros, valores dinámicos y task values
  • ›Triggers: programados, por eventos de archivo y continuos
  • ›Lógica condicional, ciclos (For Each) y reintentos
  • ›Repair runs, alertas y notificaciones
  • ›Troubleshooting: Spark UI, logs y errores comunes
08Git, Databricks Bundles & CI/CD
  • ›Integración con Git y flujos de trabajo con Repos
  • ›Introducción a Databricks Asset Bundles (DABs)
  • ›Estructura de un bundle: recursos, targets y variables
  • ›Despliegue multi-ambiente (dev, staging, prod)
  • ›Pipelines de CI/CD con GitHub Actions
  • ›Pruebas automatizadas para código de datos
09Unity Catalog: Governance & Production Readiness
  • ›Modelo de objetos: metastore, catálogos, esquemas y tablas
  • ›Gestión de permisos, roles y principio de mínimo privilegio
  • ›Managed vs. External tables y volúmenes
  • ›Row filters, column masks y protección de datos sensibles
  • ›Linaje de datos, auditoría y system tables
  • ›Delta Sharing y compartición segura de datos
  • ›Checklist de preparación para producción
10Data for AI: Preparando Datos para Agentes
  • ›Por qué la calidad de los datos define el éxito de la IA
  • ›Preparación de datos estructurados y no estructurados
  • ›Feature engineering y Feature Stores
  • ›Vector Search: embeddings e índices vectoriales
  • ›Pipelines de datos para casos de uso RAG
  • ›Gobierno y trazabilidad de datos para aplicaciones de IA
11Genie Agents: Conversa con tus Datos
  • ›Qué es Genie y cómo funciona el análisis en lenguaje natural
  • ›Creación de un Genie space y selección de tablas
  • ›Instrucciones, ejemplos de SQL y metadatos que mejoran las respuestas
  • ›Benchmarks y evaluación de la precisión de Genie
  • ›Seguridad y permisos heredados de Unity Catalog
  • ›Casos de uso de negocio y adopción en la organización
12Proyecto End-to-End & Preparación para Certificación
  • ›Definición del caso de uso y arquitectura de la solución
  • ›Ingesta incremental con Auto Loader y capas medallion
  • ›Pipeline declarativo con calidad de datos y orquestación con Jobs
  • ›Despliegue con Bundles y CI/CD
  • ›Gobierno con Unity Catalog y consumo con Genie
  • ›Guía de examen, simulacro y estrategias para aprobar la certificación

// Tus instructores

Aprendes con quienes lo hacen a diario

Daniel Alejandro Santos pareja, instructor del bootcamp

Daniel Alejandro Santos pareja

Ing de datos

Bachiller en Ingeniería de Sistemas con más de 5 años de experiencia como Data Engineer, combinando habilidades en automatización, análisis de datos e inteligencia artificial para ayudar a empresas a tomar decisiones más inteligentes y escalar con eficiencia.

LinkedIn
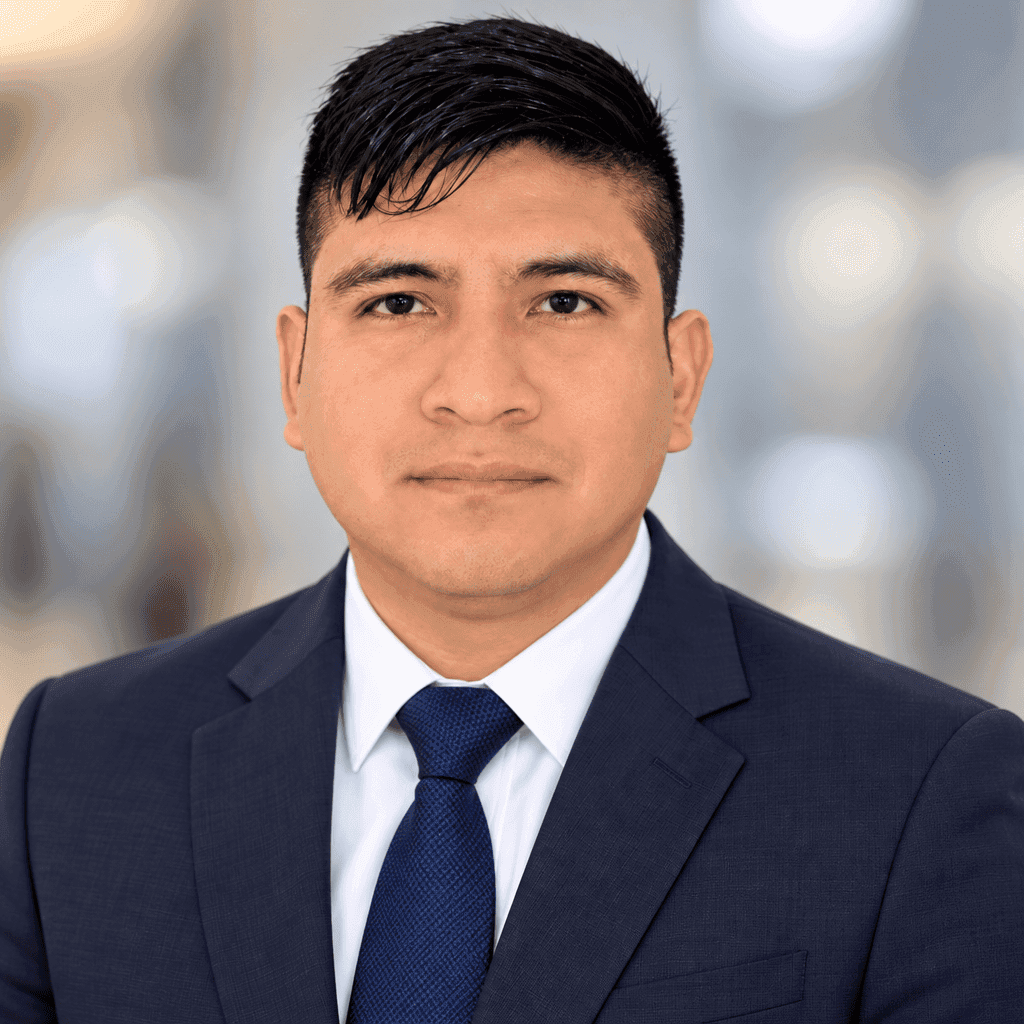
Kremlin  Huaman, instructor del bootcamp

Kremlin Huaman

Senior Data Engineer - Minsur

Senior Data Engineer con más de 8 años de experiencia en ingeniería de datos, analítica e inteligencia artificial en sectores como minería y banca. Mi enfoque profesional está evolucionando hacia el liderazgo técnico, la arquitectura de datos y la dirección de iniciativas que conecten tecnología, negocio y estrategia.

LinkedIn

Es para ti si…

  • Analistas de datos o BI que quieren dar el salto a ingeniería
  • Desarrolladores que quieren especializarse en datos
  • Data engineers que vienen de otras plataformas y migran a Databricks
  • Quienes preparan la certificación Databricks Data Engineer

No es para ti si…

  • Buscas solo teoría: aquí se construye en cada módulo
  • Quieres un curso de ciencia de datos o de modelos de machine learning

// Inscripción

Databricks Data Engineering

Inicia el miércoles, 4 de noviembre de 2026 · 07:00 p. m. (hora de Lima)

Lunes y miércoles · del 4 de noviembre al 16 de diciembre
US$ 230.00US$ 300.00Ahorras 23%
  • 36 horas de clases en vivo con los instructores
  • 12 módulos prácticos, del Lakehouse a producción
  • Proyecto end-to-end para tu portafolio
  • Preparación para las certificaciones Databricks y Microsoft: guía y simulacro
  • Certificado de participación Datahackers
Reservar mi cupo
Tarjeta o PayPal · pago 100% seguroTarjetas aceptadas

// Preguntas frecuentes

Antes de inscribirte

¿Necesito experiencia previa?

El bootcamp empieza desde los fundamentos de la plataforma. Te ayuda tener nociones de SQL y algo de Python, porque desde el módulo 2 trabajamos con PySpark y Spark SQL.

¿Incluye el examen de certificación?

Incluye la preparación para la Databricks Certified Data Engineer Associate y la Microsoft Certified: Azure Databricks Data Engineer Associate (examen DP-750): guía de examen, simulacro y estrategias para aprobar. El examen oficial se rinde directamente con el proveedor y se paga aparte.

¿Qué días y a qué hora son las clases?

Lunes y miércoles, a las 7:00 p.m. hora de Perú (6:00 p.m. México, 8:00 p.m. Bolivia, 9:00 p.m. Chile y Argentina), del 4 de noviembre al 16 de diciembre.

¿Las clases son en vivo?

Sí. Son sesiones en vivo con los instructores, donde puedes preguntar y resolver dudas mientras construyes.

¿Cómo puedo pagar?

Con tarjeta de crédito o débito. Desde Perú también puedes pagar con Yape; desde otros países, con PayPal. El pago es en línea y el acceso se activa al confirmarse.

¿Qué obtengo al terminar?

Un proyecto end-to-end para tu portafolio y el certificado de participación de Datahackers.

Inicia el miércoles, 4 de noviembre de 2026

Tu próximo rol empieza con un pipeline en producción

36 horas en vivo, 12 módulos y un proyecto real para mostrar en entrevistas.

Bootcamp

US$ 230.00

Reservar mi cupo